第 5 章 上下文无关文法及上下文无关语言
从线性扫描到递归结构:CFG、分析树与歧义
Source scope
主要依据教材第 5 章:中文印刷页 115–148 左右,对应 PDF p.128–161;随后是参考文献与章节过渡页。教材先定义 CFG,再讨论语法分析树、编译/标记语言应用以及歧义性。
1 0. 为什么需要上下文无关文法
有限自动机只能保存有限状态,因此不能表达任意深度的嵌套。例如:
- 成对括号;
- 算术表达式的递归嵌套;
- \(\{0^n1^n\mid n\ge0\}\)。
上下文无关文法(context-free grammar, CFG)通过递归产生式描述这些结构。
2 1. CFG 的正式定义
一个 CFG 是四元组
\[ G=(V,T,P,S), \]
其中:
- \(V\):变量(非终结符)集合;
- \(T\):终结符集合;
- \(P\):产生式集合;
- \(S\in V\):开始符号。
每条产生式形如
\[ A\to \alpha, \]
其中 \(A\in V\),\(\alpha\in(V\cup T)^*\)。
“上下文无关”的关键是:左侧只有一个变量 \(A\),不需要查看 \(A\) 周围的上下文就可以替换它。
3 2. 推导、句型与语言
若某句型中出现变量 \(A\),且有产生式 \(A\to\alpha\),则
\[ xAy\Rightarrow x\alpha y. \]
多步推导记为
\[ \Rightarrow^*. \]
由 \(S\) 可推导出的任意 \((V\cup T)^*\) 串称为句型;只含终结符的句型称为句子。
文法语言为
\[ L(G)=\{w\in T^*\mid S\Rightarrow^* w\}. \]
3.1 2.1 例:\(\{0^n1^n\mid n\ge0\}\)
文法
\[ S\to 0S1\mid \varepsilon \]
生成:
\[ S\Rightarrow0S1\Rightarrow00S11\Rightarrow0011. \]
每递归一次,左边增加一个 0,右边增加一个 1,因此数量始终配对。
4 3. 最左推导与最右推导
最左推导:每一步替换当前最左变量。
最右推导:每一步替换当前最右变量。
同一棵语法分析树通常对应一个最左推导和一个最右推导;一般推导顺序可以很多。
区分:不同推导顺序不一定意味着歧义。歧义关心的是是否存在不同的语法分析树。
5 4. 语法分析树
语法分析树(parse tree)把推导的层次结构显式画出来。
规则:
- 根是开始符号 \(S\);
- 内部节点是变量;
- 若使用产生式 \(A\to X_1X_2\cdots X_k\),则 \(A\) 的孩子从左到右为 \(X_1,\ldots,X_k\);
- 从左到右读取叶子终结符得到树的产出(yield)。
5.1 4.1 树与推导的等价关系
- 每个推导都能构造相应分析树;
- 每棵分析树都能按最左或最右顺序线性化成推导。
因此“文法生成某串”和“存在该串的分析树”是等价的。
6 5. 典型文法设计
6.1 5.1 平衡括号
一种 CFG:
\[ S\to SS\mid (S)\mid\varepsilon. \]
它表达了两种递归结构:
- 两个平衡串连接;
- 一个平衡串外面再包一层括号。
6.2 5.2 算术表达式
若只写
\[ E\to E+E\mid E*E\mid(E)\mid id, \]
会产生歧义。例如 id+id*id 可以按不同根运算符解析。
一个常用无歧义文法:
\[ \begin{aligned} E&\to E+T\mid T,\\ T&\to T*F\mid F,\\ F&\to(E)\mid id. \end{aligned} \]
层次 \(E/T/F\) 把优先级编码进文法结构。
7 6. CFG 的应用
教材把 CFG 与几个现实场景联系起来。
7.1 6.1 语法分析器
编译器通常分为:
源程序
  ↓ 词法分析(正则语言)
token 流
  ↓ 语法分析(CFG)
语法分析树 / AST
这解释了为什么第 3 章与第 5 章在编译原理中连续出现。
7.2 6.2 YACC
YACC 类工具以文法规则为输入,自动生成语法分析器。理论 CFG 是其数学基础,而工程工具通常还需要:
- 冲突处理;
- 运算符优先级;
- 语义动作。
7.3 6.3 标记语言与 XML
教材用 HTML/XML 说明“嵌套结构”天然适合文法描述:元素的开始与结束标记形成递归层次。
DTD 可以把合法文档结构描述成类似 CFG 的规则系统。
8 7. 歧义
8.1 7.1 歧义文法
若存在某个串 \(w\in L(G)\),具有两棵不同语法分析树,则 \(G\) 是歧义文法。
等价判据:存在某个串具有两个不同最左推导(或两个不同最右推导)。
8.2 7.2 去除文法歧义
很多编程语言表达式文法可以通过:
- 分层优先级;
- 固定结合性;
- 拆分变量类别
消除歧义。
但并非所有 CFL 都存在无歧义 CFG。
8.3 7.3 固有歧义语言
如果一个语言的每一个 CFG 都歧义,则称该语言固有歧义(inherently ambiguous)。
这强调:
“文法歧义”是某个表示的问题;“固有歧义”是语言本身的问题。
9 8. 设计 CFG 的方法
- 先找递归结构;
- 明确递归一次对应字符串增加什么;
- 选择终止条件;
- 证明 soundness:生成的串都合法;
- 证明 completeness:每个合法串都能生成。
对语言
\[ L=\{0^i1^j2^k\mid i=j\text{ 或 }j=k\}, \]
常用“按情况取并”的策略:
\[ L=L_1\cup L_2, \]
分别为 \(L_1,L_2\) 设计 CFG,再通过新开始符号取并。
10 9. 常见错误
- 把变量与终结符混用;
- 只展示几个推导例子就声称证明了语言相等;
- 把一般推导顺序差异误判为歧义;
- 忽略空串;
- 算术表达式文法没有编码优先级与结合性;
- 设计文法时只证明“能生成一些合法串”,没有证明“不会生成非法串”。
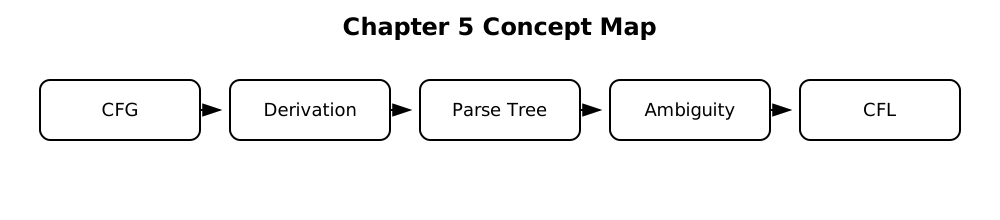
11 10. 与后续章节连接
第 6 章将证明:
\[ \boxed{\text{CFG}\equiv\text{PDA}} \]
第 7 章进一步研究 CFL 的泵引理、封闭性、范式与判定性质。