第 3 章 正则表达式与正则语言
从正则表达式到自动机:同一种语言类的多种表示
Source scope
主要依据教材第 3 章:中文印刷页 57–84,对应 PDF p.70–97。本文是自包含讲义;教材之外用于补足直觉、证明步骤和算法伪代码的内容会明确标作“补充说明”。
1 0. 本章主线
第 2 章已经建立 DFA、NFA 和 \(\varepsilon\)-NFA。第 3 章引入另一种描述正则语言的方式:正则表达式(regular expression, RE)。
最核心结论是
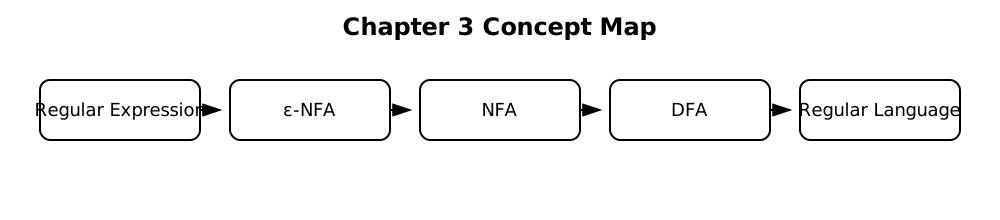
\[ \boxed{\text{Regular Expression}\equiv \varepsilon\text{-NFA}\equiv \text{NFA}\equiv \text{DFA}} \]
这不是记忆题,而是整门课第一次出现“不同计算表示具有相同表达能力”的典型范式。
学完本章,应能:
- 按正式语义解释正则表达式;
- 在并、连接、Kleene 星之间正确处理优先级;
- 从语言描述构造正则表达式;
- 把 DFA 转换为正则表达式;
- 用 Thompson 风格构造把正则表达式转为 \(\varepsilon\)-NFA;
- 理解正则表达式在 UNIX、词法分析和文本搜索中的作用;
- 使用正则表达式代数定律进行等价变换。
2 1. 正则表达式的形式语义
设字母表为 \(\Sigma\)。正则表达式递归定义如下。
- \(\emptyset\) 是正则表达式,表示空语言: \[L(\emptyset)=\emptyset.\]
- \(\varepsilon\) 是正则表达式,表示只含空串的语言: \[L(\varepsilon)=\{\varepsilon\}.\]
- 对每个 \(a\in\Sigma\),\(a\) 是正则表达式,且 \[L(a)=\{a\}.\]
- 若 \(R,S\) 是正则表达式,则:
- \(R+S\) 表示并:\(L(R+S)=L(R)\cup L(S)\);
- \(RS\) 表示连接:\(L(RS)=L(R)L(S)\);
- \(R^*\) 表示 Kleene 星:\(L(R^*)=L(R)^*\)。
2.1 1.1 三个最容易混淆的对象
必须区分:
- 正则表达式 \(R\):一个语法对象;
- 语言 \(L(R)\):\(R\) 所表示的字符串集合;
- 字符串 \(w\):语言中的一个元素。
例如 \(R=0^*1\),那么 \(R\) 不是字符串集合;真正的集合是
\[ L(R)=\{1,01,001,0001,\ldots\}. \]
2.2 1.2 运算优先级
教材采用的常规优先级是:
\[ * \quad > \quad \text{连接} \quad > \quad +. \]
所以
\[ 0+10^* \]
解析为
\[ 0+(1(0^*)). \]
而不是 \((0+1)0^*\)。
常见错误:把 \(R^*\) 理解成“至少一次”。
正确的是“零次或多次”,所以 \(\varepsilon\in L(R^*)\) 永远成立。
3 2. 如何从语言描述构造正则表达式
3.1 2.1 分块思维
构造正则表达式时,不要直接猜完整式子。先问:
- 一个合法串可以分成哪些连续块?
- 每个块有什么局部约束?
- 块之间是“选择”“连接”还是“重复”?
例如二进制语言
所有以
01结尾的串。
前缀可以任意,因此
\[ (0+1)^*01. \]
3.2 2.2 “包含某子串”的通用模板
语言“包含固定模式 \(p\)”通常写成
\[ \Sigma^*p\Sigma^*. \]
例如包含 101:
\[ (0+1)^*101(0+1)^*. \]
3.3 2.3 “不包含某模式”为什么更难
正则表达式天然适合描述“存在一种结构”;对于“不出现某模式”,直接写 RE 往往不如先设计 DFA,再转为 RE。
这是本章一个重要策略:
选择最适合当前问题的表示,再做表示转换。
4 3. 从 DFA 到正则表达式
教材给出“从自动机消除状态”的思路。直觉上,我们把一条经过内部状态的多段路径压缩成一条标有正则表达式的边。
4.1 3.1 广义转移标签
普通 DFA 的边标签是单个输入符号。状态消除过程中允许边标签变为正则表达式。
若从 \(i\) 到 \(j\) 有若干并行路径,则合并为
\[ R_{ij}=R_1+R_2+\cdots. \]
若消除状态 \(k\),则原本从 \(i\) 经 \(k\) 到 \(j\) 的所有路径贡献
\[ R_{ik}(R_{kk})^*R_{kj}. \]
因此更新公式是
\[ \boxed{R'_{ij}=R_{ij}+R_{ik}(R_{kk})^*R_{kj}}. \]
4.2 3.2 为什么这个公式正确
一条从 \(i\) 到 \(j\)、且内部使用 \(k\) 的路径具有三段:
- 先从 \(i\) 到 \(k\);
- 在 \(k\) 上绕若干圈,次数可以是 \(0,1,2,\dots\);
- 再从 \(k\) 到 \(j\)。
这三段分别对应
\[ R_{ik},\quad (R_{kk})^*,\quad R_{kj}. \]
把“直接去 \(j\)”与“经 \(k\) 去 \(j\)”取并,就得到更新公式。
4.3 3.3 消除顺序会影响表达式外观
不同状态消除顺序通常产生不同正则表达式,但它们表示同一个语言。
这说明:
正则表达式的语法形式不唯一,重要的是它们表示的语言是否相同。
5 4. 从正则表达式到自动机
教材通过递归构造证明每个正则表达式都能转成自动机。最方便的版本是构造 \(\varepsilon\)-NFA。
5.1 4.1 基础构件
对 \(\emptyset\)、\(\varepsilon\)、单字符 \(a\),分别建立极小自动机。
- \(a\):初态经过标记 \(a\) 的边到终态;
- \(\varepsilon\):初态经过 \(\varepsilon\) 边到终态;
- \(\emptyset\):没有从初态到终态的可接受路径。
5.2 4.2 并 \(R+S\)
新增初态和终态:
- 新初态通过 \(\varepsilon\) 分叉进入 \(R\) 或 \(S\);
- 两个子自动机的终态通过 \(\varepsilon\) 汇合到新终态。
5.3 4.3 连接 \(RS\)
把 \(R\) 的终态通过 \(\varepsilon\) 连到 \(S\) 的初态。
5.4 4.4 闭包 \(R^*\)
必须同时表达:
- 可以一次都不执行 \(R\);
- 可以执行一次;
- 可以执行任意多次。
因此新增 \(\varepsilon\) 边允许“直接接受”和“从 \(R\) 终态回到 \(R\) 初态”。
5.5 4.5 归纳证明框架
定理:每个正则表达式 \(R\) 都存在一个 \(\varepsilon\)-NFA \(N_R\),使得
\[ L(N_R)=L(R). \]
证明对正则表达式的递归结构做结构归纳:
- 基础情况:\(\emptyset,\varepsilon,a\);
- 归纳情况:\(R+S,RS,R^*\)。
这正是第 1 章结构归纳的直接应用。
6 5. 正则表达式的应用
6.1 5.1 UNIX 风格正则表达式
教材强调:实际工具中的“正则表达式”通常加入语法糖,例如:
- 字符类
[0-9]; - 可选、重复次数;
- 转义字符;
- 通配符。
从理论视角,应区分:
- 经典正则表达式:表达能力恰好等于有限自动机;
- 某些现代正则引擎的扩展(如反向引用):可能超出经典正则语言能力。
本课程讨论的是前者。
6.2 5.2 词法分析
编译器前端常把 token 类写成正则表达式:
- identifier;
- integer;
- keyword;
- operator;
- whitespace。
典型流水线:
正则表达式
   ↓
ε-NFA
   ↓
DFA
   ↓
最小化/实现
   ↓
词法分析器
6.3 5.3 文本搜索
若要在长文本中寻找模式 \(R\),可以构造识别
\[ \Sigma^*L(R) \]
或
\[ \Sigma^*L(R)\Sigma^* \]
的自动机,并在扫描中持续更新状态。
7 6. 正则表达式代数定律
教材系统讨论了结合律、交换律、单位元、零元、分配律、幂等律及闭包相关定律。
一些常用等价式:
\[ R+S=S+R, \]
\[ (R+S)+T=R+(S+T), \]
\[ R(S+T)=RS+RT, \]
\[ R+R=R, \]
\[ R+\emptyset=R, \]
\[ R\varepsilon=\varepsilon R=R, \]
\[ \emptyset R=R\emptyset=\emptyset. \]
但必须注意:连接一般不交换,即通常
\[ RS\ne SR. \]
7.1 6.1 闭包的重要恒等式
\[ R^*=\varepsilon+RR^*=\varepsilon+R^*R. \]
这表示“零次,或先取一次 \(R\) 再继续任意多次”。
8 7. 本章知识地图
Regular Expression
   ├─ union / concatenation / star
   ├─ algebraic laws
   ├─ UNIX / lexical analysis / search
   ├─→ ε-NFA (recursive construction)
   └─← DFA (state elimination)

因此:RE = ε-NFA = NFA = DFA = Regular Languages
9 8. 常见错误
- 把 \(\emptyset\) 与 \(\varepsilon\) 混淆;
- 忘记 \(R^*\) 一定包含 \(\varepsilon\);
- 把
+当作字符串中的普通字符; - 忽略运算优先级;
- 把两个语法不同的正则表达式误认为语言不同;
- 做 DFA→RE 时漏掉被消除状态上的自环;
- 做 RE→NFA 时忘记结构归纳的基础构件;
- 误认为所有工程“regex”功能都严格等于正则语言。
10 9. 本章结论
第 3 章建立了第一个完整的表示等价网络。以后我们研究“正则语言的性质”时,可以自由选择最方便的表示:
- 做闭包证明时常用自动机构造;
- 做模式描述时常用正则表达式;
- 做判定和最小化时常用 DFA。