第 1 章 自动机:方法与体验
自动机、形式化证明、归纳法与形式语言的基础词汇
Source scope
本章以 Hopcroft–Motwani–Ullman《自动机理论、语言和计算导论》第三版中文译本第 1 章为主要依据:中文印刷页 1–24,对应 PDF p.14–37。教材第 2 章从 PDF p.38 开始。本文是自包含学习笔记,不是教材逐字转写;为补足教材略写之处而加入的解释、推导和额外例子,会明确标为“补充说明”或“扩展示例”。
1 0. 本章在整门课中的位置
如果把整门计算理论课程压缩成一句话,它研究的是:
什么可以被计算?什么可以被某种受限模型计算?计算一件事需要多少资源?
后面的 DFA、NFA、正则表达式、CFG、PDA、图灵机、不可判定性和 NP 完全性,都会反复使用第 1 章建立的三套语言:
- 模型语言:状态、输入、行为、结构表示;
- 证明语言:直接证明、等价证明、逆否、反证、归纳;
- 对象语言:字母表、串、语言、问题。
因此第 1 章不是“可以跳过的绪论”。如果本章中的证明方法和符号不熟,后面会在“DFA 等价”“泵引理”“CFG 推导”“不可判定性归约”等位置不断卡住。
1.1 0.1 学习目标
学完本章后,你应该能够:
- 用“状态 + 输入 + 状态变化”的视角描述一个简单系统;
- 理解为什么自动机理论既是一门模型理论,也是一门关于可计算性与复杂性的基础理论;
- 判断一个证明应该使用直接证明、集合双包含、逆否、反证、反例还是归纳;
- 独立写出标准数学归纳法与结构归纳法的证明骨架;
- 熟练区分字母表、符号、串、空串、串长、串联接、串的幂、语言;
- 熟练区分 \(\varnothing\) 与 \(\{\varepsilon\}\);
- 把一个“是/否问题”理解为某个字母表上的语言。
2 1. 为什么研究自动机理论
2.1 1.1 什么是“自动机”
最朴素地说,自动机(automaton) 是一个按照规则接收输入、维护内部状态并产生行为的抽象机器。
一个状态型系统通常包含三类要素:
- 状态(state):系统当前“记住”的有限信息;
- 输入(input):来自外部的事件或符号;
- 转移(transition):收到输入以后,状态如何改变。
这种观点的重要性在于:很多系统的全部历史非常复杂,但决定下一步行为时并不需要保存整个历史,只需要保存“对未来有用的摘要”。这个摘要就是状态。
2.1.1 例 1:按钮控制的灯
考虑一盏只有 off 和 on 两个状态的灯。每次按下按钮 Push,状态翻转一次。
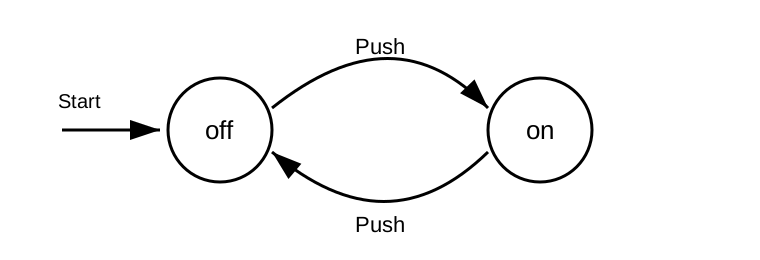
这个例子非常小,但已经包含了后面 DFA 的核心思想:
- 有一个有限状态集合;
- 有输入事件;
- 每个“当前状态 + 输入”决定下一状态。
先不要把它和 DFA 的正式五元组混在一起。 第 1 章只是在建立直觉,第 2 章才会给出确定型有穷自动机的正式定义。
2.2 1.2 自动机的一个基本用途:识别模式
自动机可以被看作“识别器”。例如,我们希望在一个字符流中判断是否已经依次看到单词 then。最简单的状态解释是:
- \(q_0\):还没有匹配任何字符;
- \(q_1\):已经匹配
t; - \(q_2\):已经匹配
th; - \(q_3\):已经匹配
the; - \(q_4\):已经匹配
then。
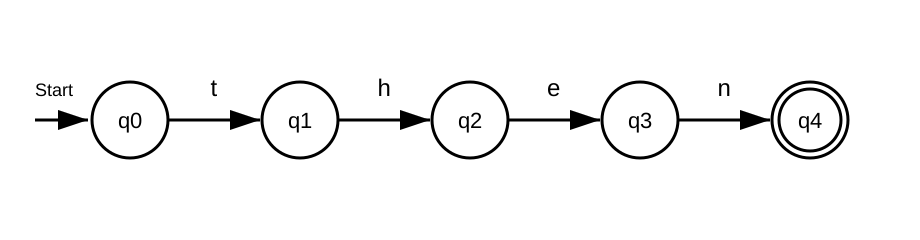
这个例子说明了一个非常重要的建模思想:
状态不是“机器长什么样”,而是“为了完成任务,机器到目前为止必须记住什么”。
后面设计 DFA/NFA 时,真正困难的部分往往不是画箭头,而是找出“应该记住的最小信息”。
2.3 1.3 为什么这种理论值得单独研究
教材开篇强调,自动机理论并不是为了研究几个玩具状态图。它在计算机科学中承担了几类基础角色。
2.3.1 1.3.1 作为软件与硬件系统的抽象模型
状态机适合描述:
- 数字电路的控制逻辑;
- 通信协议;
- 软件界面状态;
- 词法分析器;
- 文本模式匹配;
- 某些控制系统和工作流。
抽象的好处是:我们可以忽略实现细节,只保留与行为正确性有关的部分。
2.3.2 1.3.2 作为“能力边界”的研究工具
对一个计算模型,可以问两个层次的问题:
- 它能解决什么问题?
- 它不能解决什么问题?
例如,后面会证明:
- DFA 能识别的恰好是正则语言;
- PDA 能识别更广的某类语言;
- 图灵机表达了一般意义上的算法计算;
- 即使图灵机也存在无法判定的问题。
这就把“程序能不能写出来”从经验问题提升成可以证明的数学命题。
2.3.3 1.3.3 从可判定性到复杂性
仅仅知道“有算法”还不够。还要问:算法是不是足够高效?
因此理论计算机科学里经常区分:
- 可判定性 / 可计算性(decidability / computability):是否存在算法最终给出正确答案;
- 易处理性 / 复杂性(tractability / complexity):如果存在算法,它需要多少时间、空间等资源。
本书后半部分会把这条线推进到不可判定性以及 \(P\)、\(NP\)、NP 完全性。
3 2. 结构表示:不要只用自然语言描述系统
自然语言很方便,但容易歧义。形式化方法通常需要一种结构表示(structural representation):把对象的组成方式明确地写出来。
常见结构表示包括:
- 图(graph):状态作为节点,转移作为边;
- 表(table):把状态与输入对应到下一状态;
- 代数式 / 正则表达式:用运算符组合简单模式;
- 文法(grammar):用产生式递归生成结构;
- 递归定义:给出基础对象和构造规则;
- 语法树 / 结构树:显示对象由哪些子对象组合而成。
这些表示不是互相替代的“画法”,而是各自更适合某类证明和算法。后面整门课的一个反复主题就是:
同一个语言可以有多种表示;我们既要证明这些表示等价,也要研究如何在表示之间转换。
4 3. 形式化证明:从“我觉得对”到“我能证明”
自动机理论的大量核心结论都不是靠计算几个例子得到的,而是需要对所有可能输入进行论证。因此必须熟悉证明。
4.1 3.1 命题、定理、引理、推论
- 命题(proposition):可以判断真假的陈述;
- 定理(theorem):重要且已经证明的命题;
- 引理(lemma):通常为证明更大结果服务的中间结论;
- 推论(corollary):从某个已知结论几乎直接推出的结果。
名称不是重点。重点是:结论必须建立在明确的假设与逻辑推导上。
4.2 3.2 “如果……那么……”的逻辑结构
大量定理可以写成
\[ P \Rightarrow Q. \]
这里:
- \(P\) 是假设(hypothesis);
- \(Q\) 是结论(conclusion)。
要证明它,并不是证明 \(P\) 本身,也不是证明 \(Q\) 无条件成立,而是证明:
在假设 \(P\) 成立的前提下,\(Q\) 必然成立。
4.3 3.3 直接证明 / 演绎证明
直接证明的标准形式是:
- 假设前提 \(P\);
- 使用定义、已知事实和已经证明的定理;
- 一步步推出 \(Q\)。
4.3.1 扩展示例:偶数加偶数仍是偶数
要证明:若 \(a,b\) 都是偶数,则 \(a+b\) 是偶数。
根据偶数定义,存在整数 \(m,n\),使得
\[ a=2m,\qquad b=2n. \]
于是
\[ a+b=2m+2n=2(m+n). \]
由于 \(m+n\in\mathbb Z\),所以 \(a+b\) 是偶数。
注意,这个证明的关键不是“举了几个偶数相加的例子”,而是直接展开定义。
5 4. 求助于定义:证明中最常被忽略的第一步
遇到一个术语时,第一反应应该是:
它的正式定义是什么?
例如,要证明一个集合为空、一个整数是偶数、一个串属于某个语言、一个 DFA 接受某个串,首先都应当展开相关定义。
后面很多“看起来很难”的证明,实际上只是:
- 写出定义;
- 把定义中的量代入;
- 做逻辑或代数化简。
5.1 4.1 “当且仅当”必须证明两个方向
命题
\[ P \iff Q \]
等价于同时证明
\[ P\Rightarrow Q \quad\text{和}\quad Q\Rightarrow P. \]
证明时最好明确写出两个方向:
- 必要性:\(P\Rightarrow Q\);
- 充分性:\(Q\Rightarrow P\)。
常见错误:证明了一个方向,就写“所以 iff 成立”。这是不完整的。
6 5. 集合相等:最稳妥的方法是双包含
若要证明两个集合 \(R,S\) 相等,最常用的方法是证明:
\[ R\subseteq S \quad\text{且}\quad S\subseteq R. \]
6.1 5.1 标准模板
证明 \(R\subseteq S\):
- 任取 \(x\in R\);
- 根据 \(R\) 的定义推出关于 \(x\) 的性质;
- 推出 \(x\in S\)。
再交换 \(R,S\),证明 \(S\subseteq R\)。
6.2 5.2 为什么这个技巧对形式语言特别重要
语言本质上就是字符串集合。后面我们经常要证明:
- 两个自动机识别同一个语言;
- 一个正则表达式与一个 DFA 表示同一个语言;
- 两个 CFG 生成同一个语言。
于是“语言相等”经常转化成“任意串 \(w\) 属于左边 iff 属于右边”。
7 6. 逆否命题
命题
\[ P\Rightarrow Q \]
与它的逆否命题
\[ \neg Q\Rightarrow \neg P \]
逻辑等价。
因此,当正面从 \(P\) 推到 \(Q\) 很困难,而“假设 \(Q\) 不成立”会提供更强信息时,逆否证明非常有用。
7.0.1 扩展示例:若 \(n^2\) 为偶数,则 \(n\) 为偶数
直接证明并不自然。证明逆否命题:
若 \(n\) 为奇数,则 \(n^2\) 为奇数。
设 \(n=2k+1\),则
\[ n^2=(2k+1)^2=4k^2+4k+1=2(2k^2+2k)+1, \]
所以 \(n^2\) 是奇数。于是原命题成立。
逆命题 \(Q\Rightarrow P\) 与 逆否命题 \(\neg Q\Rightarrow\neg P\) 完全不是一回事。原命题一般不与逆命题等价。
8 7. 反证法
反证法要证明命题 \(P\) 时,先假设 \(\neg P\),再推出矛盾。
证明骨架:
- 假设结论不成立;
- 连同已有条件继续推理;
- 推出不可能事件,例如 \(A\land\neg A\)、违反定义、违反已知定理;
- 因而最初的否定假设错误,\(P\) 成立。
反证法在后面的不可判定性证明中非常常见:经常假设“存在一个可以解决某问题的机器”,然后用它构造出逻辑矛盾。
9 8. 反例:推翻全称命题只需要一个例子
要证明
\[ \forall x,\ P(x) \]
是假的,只需要找到一个 \(x_0\),使得 \(P(x_0)\) 不成立。
这就是反例(counterexample)。
例如,命题“所有素数都是奇数”是假的,因为 \(2\) 是素数但不是奇数。
请注意逻辑上的不对称:
- 证明全称命题:通常必须覆盖所有对象;
- 推翻全称命题:一个反例就够。
10 9. 数学归纳法
归纳法解决的是这样一类问题:命题 \(P(n)\) 对无穷多个整数 \(n\) 都要成立,我们不可能逐个验证。
10.1 9.1 标准归纳原理
要证明对所有 \(n\ge n_0\),\(P(n)\) 成立,通常分两步:
10.1.1 基础步骤(basis)
证明
\[ P(n_0) \]
成立。
10.1.2 归纳步骤(inductive step)
假设某个 \(k\ge n_0\) 时 \(P(k)\) 成立,这个假设叫归纳假设(inductive hypothesis);然后证明
\[ P(k+1) \]
也成立。
完成这两步后,即可推出 \(P(n)\) 对所有 \(n\ge n_0\) 成立。
10.2 9.2 教材典型例子:平方和公式
教材在归纳部分使用了平方和公式作为典型证明对象:
\[ \sum_{i=1}^{n} i^2 = \frac{n(n+1)(2n+1)}{6}. \]
10.2.1 基础步骤
当 \(n=1\) 时,
\[ 1^2=1 = \frac{1\cdot 2\cdot 3}{6}. \]
成立。
10.2.2 归纳假设
假设对 \(n=k\) 成立,即
\[ \sum_{i=1}^{k} i^2 = \frac{k(k+1)(2k+1)}{6}. \]
10.2.3 证明 \(k+1\)
\[ \begin{aligned} \sum_{i=1}^{k+1} i^2 &= \left(\sum_{i=1}^{k} i^2\right)+(k+1)^2\\ &= \frac{k(k+1)(2k+1)}{6}+(k+1)^2\\ &= (k+1)\left(\frac{k(2k+1)}{6}+k+1\right)\\ &= (k+1)\frac{2k^2+7k+6}{6}\\ &= \frac{(k+1)(k+2)(2k+3)}{6}. \end{aligned} \]
而这正是把 \(n\) 替换为 \(k+1\) 后的右端:
\[ \frac{(k+1)((k+1)+1)(2(k+1)+1)}{6}. \]
所以归纳步骤成立。
10.3 9.3 教材中的另一个典型增长比较
教材还通过类似
\[ 2^n>n^2\qquad(n>4) \]
的命题展示归纳推理。
10.3.1 基础情况
\[ 2^5=32>25=5^2. \]
10.3.2 归纳假设
假设 \(2^k>k^2\),其中 \(k\ge5\)。
则
\[ 2^{k+1}=2\cdot 2^k>2k^2. \]
只需再验证
\[ 2k^2>(k+1)^2. \]
等价于
\[ k^2-2k-1>0. \]
对 \(k\ge5\) 显然成立。因此 \(2^{k+1}>(k+1)^2\)。
这个例子提醒我们:
归纳步骤中不能只说“显然继续成立”,必须真正把 \(P(k)\) 转化为 \(P(k+1)\)。
11 10. 更一般的整数归纳
教材随后把标准归纳推广到更一般的形式。学习时至少要掌握以下三种变体。
11.1 10.1 从任意起点 \(n_0\) 开始
并不是所有命题都从 \(n=0\) 或 \(n=1\) 开始。例如上面的 \(2^n>n^2\) 从 \(n=5\) 才适合作为严格不等式的起点。
11.2 10.2 多个基础情况
如果 \(P(k+1)\) 的证明需要用到多个之前的值,例如 \(P(k)\) 与 \(P(k-1)\),那么往往要先验证多个基础情况。
11.3 10.3 强归纳(补充说明)
强归纳的归纳假设是:
\[ P(n_0),P(n_0+1),\dots,P(k) \]
全部成立,然后证明 \(P(k+1)\)。
它与普通归纳在逻辑能力上等价,但在“一个对象由多个更小对象组成”的证明里更自然。
12 11. 结构归纳法
整数归纳是沿着
\[ 0,1,2,3,\dots \]
这样的线性结构递推;而很多计算机科学对象不是按整数线性生成,而是递归构造出来的,例如:
- 算术表达式;
- 语法树;
- 正则表达式;
- CFG 推导树;
- 递归定义的字符串集合。
这时使用结构归纳(structural induction)。
12.1 11.1 结构归纳的两部分
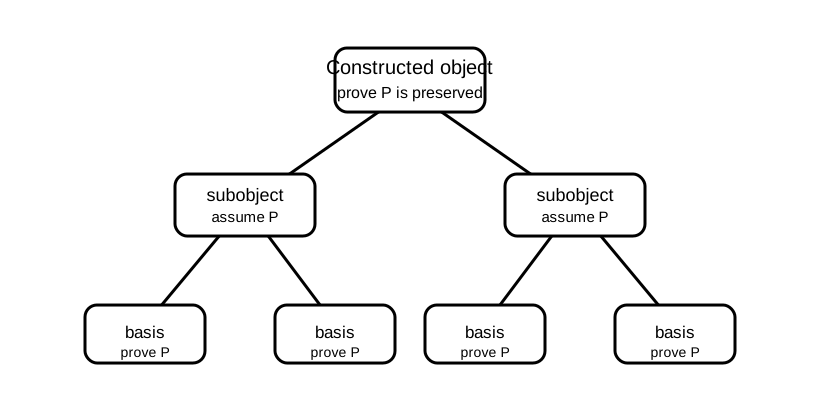
假设集合 \(S\) 通过以下方式递归定义:
- 一些基础对象属于 \(S\);
- 如果若干较小对象属于 \(S\),那么通过某些构造规则可得到新对象,且新对象也属于 \(S\)。
要证明 \(S\) 中每个对象都具有性质 \(P\),就证明:
- 基础情况:每个基础对象都有性质 \(P\);
- 归纳构造:假设参与构造的子对象都有性质 \(P\),证明构造出的新对象也有性质 \(P\)。
12.2 11.2 为什么它会贯穿本书
后面很多对象本身就是递归定义的:
- 正则表达式由基本表达式通过并、连接、闭包构成;
- CFG 推导树由产生式递归构成;
- 某些机器描述和公式也可递归定义。
所以证明“所有合法表达式都具有某性质”时,最自然的证明结构往往就是结构归纳。
13 12. 互归纳法
有时两个性质彼此依赖:证明 \(P\) 需要 \(Q\),证明 \(Q\) 又需要 \(P\)。这时可以把它们捆绑成一个更强的归纳命题一起证明,称为互归纳(mutual induction)。
典型骨架:
- 同时给出 \(P\) 和 \(Q\) 的基础情况;
- 假设较小结构上 \(P,Q\) 都成立;
- 分别证明新结构上的 \(P,Q\) 都成立。
这不是“循环论证”,因为归纳假设只用于更小的对象。
14 13. 自动机理论的中心概念:字母表、串与语言
从这里开始,进入后面整本书都不会离开的核心词汇。
15 14. 字母表 \(\Sigma\)
字母表(alphabet) 是一个有限的、非空的符号集合,通常记为
\[ \Sigma. \]
例如:
\[ \Sigma=\{0,1\} \]
是二进制字母表;
\[ \Sigma=\{a,b,c\} \]
也是一个字母表。
注意:
- 字母表中的元素叫符号(symbol);
- “符号”可以是字符,也可以是我们抽象出来的 token;
- 字母表是一个集合,所以不关心元素的排列顺序。
16 15. 串(string)
在字母表 \(\Sigma\) 上的一个串,是由 \(\Sigma\) 中符号组成的有限序列。
若
\[ \Sigma=\{0,1\}, \]
那么
\[ 0,\quad 101,\quad 001011 \]
都是 \(\Sigma\) 上的串。
16.1 15.1 空串 \(\varepsilon\)
长度为 0 的唯一字符串叫空串(empty string),记为
\[ \varepsilon. \]
它不包含任何符号。
特别注意:
\[ \varepsilon \neq \varnothing. \]
因为:
- \(\varepsilon\) 是一个字符串;
- \(\varnothing\) 是一个集合,而且没有任何元素。
更进一步:
\[ \{\varepsilon\}\neq\varnothing. \]
因为 \(\{\varepsilon\}\) 是一个含有一个元素的集合,这个唯一元素恰好是空串。
这是自动机理论最经典的符号陷阱之一。
16.2 15.2 串的长度
串 \(w\) 的长度记为
\[ |w|. \]
例如:
\[ |10110|=5, \qquad |\varepsilon|=0. \]
16.3 15.3 串的联接(concatenation)
若 \(x,y\) 是两个串,\(xy\) 表示先写 \(x\),再紧跟 \(y\)。
例如:
\[ x=01,\qquad y=110, \]
则
\[ xy=01110. \]
联接满足:
16.3.1 结合律
\[ (xy)z=x(yz). \]
因此通常可以直接写 \(xyz\)。
16.3.2 空串是单位元
\[ \varepsilon w=w\varepsilon=w. \]
16.3.3 一般不满足交换律
通常
\[ xy\neq yx. \]
例如 \(x=0,y=1\),则 \(xy=01\),而 \(yx=10\)。
16.3.4 长度可加
\[ |xy|=|x|+|y|. \]
16.4 15.4 串的幂
定义:
\[ w^0=\varepsilon, \]
并且对 \(k\ge1\),
\[ w^k=\underbrace{ww\cdots w}_{k\text{ 次}}. \]
例如若 \(w=ab\),则
\[ w^3=ababab. \]
17 16. \(\Sigma^k\)、\(\Sigma^*\) 与 \(\Sigma^+\)
这些记号会在后面频繁出现。
17.1 16.1 固定长度字符串集合 \(\Sigma^k\)
\[ \Sigma^k \]
表示 \(\Sigma\) 上所有长度恰好为 \(k\) 的字符串集合。
特别地:
\[ \Sigma^0=\{\varepsilon\}. \]
17.2 16.2 Kleene 星号 \(\Sigma^*\)
\[ \Sigma^*=\bigcup_{k\ge0}\Sigma^k. \]
即 \(\Sigma\) 上所有有限字符串组成的集合,其中包括空串。
17.3 16.3 正闭包 \(\Sigma^+\)
\[ \Sigma^+=\bigcup_{k\ge1}\Sigma^k. \]
所以
\[ \Sigma^+=\Sigma^*\setminus\{\varepsilon\}. \]
前提是 \(\Sigma\) 是非空字母表。
18 17. 语言(language)
给定字母表 \(\Sigma\),语言就是 \(\Sigma^*\) 的任意子集:
\[ L\subseteq\Sigma^*. \]
这个定义非常宽:
- 语言可以是有限集;
- 也可以是无限集;
- 可以包含 \(\varepsilon\);
- 也可以不包含;
- \(\varnothing\) 本身也是语言;
- \(\{\varepsilon\}\) 也是语言。
18.1 17.1 例子
在 \(\Sigma=\{0,1\}\) 上:
18.1.1 语言 A:所有以 1 结尾的串
\[ L_A=\{w\in\{0,1\}^*: w\text{ 以 }1\text{ 结尾}\}. \]
18.1.2 语言 B:0 和 1 数量相同的串
\[ L_B=\{w\in\{0,1\}^*: \#_0(w)=\#_1(w)\}. \]
其中 \(\#_0(w)\) 表示 \(w\) 中 0 的出现次数。
18.1.3 语言 C:先若干个 0,再同样多的 1
\[ L_C=\{0^n1^n:n\ge0\}. \]
这里 \(\varepsilon\in L_C\),因为取 \(n=0\) 时
\[ 0^01^0=\varepsilon\varepsilon=\varepsilon. \]
这个语言之后会成为区分“正则语言”和“上下文无关语言”的经典例子。
18.2 17.2 用集合构造式定义语言
形式语言经常写成
\[ \{w\in\Sigma^*: P(w)\}. \]
它表示:所有满足性质 \(P\) 的字符串 \(w\)。
学习自动机设计时,一个非常实用的顺序是:
- 先用一句自然语言描述目标集合;
- 再用集合构造式把语言写清楚;
- 最后设计自动机或其他表示。
这样可以避免“图画出来了,但自己都说不清它究竟识别什么语言”。
19 18. “问题”为什么可以看成语言
自动机理论与复杂性理论通常研究判定问题(decision problem),也就是答案只有“是/否”的问题。
把一个判定问题变成语言,需要两步:
- 规定如何把每个问题实例编码成字符串;
- 把所有答案为“是”的实例编码收集成一个语言。
于是:
\[ L_{\text{problem}} = \{\operatorname{enc}(x): x\text{ 是 YES 实例}\}. \]
一个算法“解决这个问题”,就等价于它能够对任意合法编码 \(w\) 判断
\[ w\in L_{\text{problem}}? \]
这一步极其重要,因为它把现实中的计算问题统一转成“语言成员性”问题。
19.1 18.1 为什么这会贯穿后半本书
以后讨论:
- 某问题是否可判定;
- 某语言是否属于 \(P\);
- 某问题是否 NP 完全;
- 一个问题如何归约到另一个问题;
本质上都依赖“问题 \(\leftrightarrow\) 语言”的对应。
20 19. 本章最容易混淆的概念
| 容易混淆 | 正确区分 |
|---|---|
| \(\varnothing\) 与 \(\varepsilon\) | 前者是空集合,后者是长度 0 的串 |
| \(\varnothing\) 与 \(\{\varepsilon\}\) | 前者有 0 个元素,后者有 1 个元素 |
符号 0 与串 0 |
语境中写法相同,但概念层级不同:前者是字母表元素,后者是长度 1 的串 |
| \(\Sigma\) 与 \(\Sigma^*\) | 前者是符号集合,后者是所有有限串的集合 |
| 直接证明与举例验证 | 举例只能提供直觉,不能证明全称命题 |
| 逆命题与逆否命题 | 原命题与逆否命题等价,与逆命题一般不等价 |
| 归纳假设与待证结论 | 只能假设 \(P(k)\),不能偷假设 \(P(k+1)\) |
| “自动机画法”与“状态含义” | 先定义状态需要记住的信息,再画图 |
21 20. 一张表记住第 1 章
| 主题 | 核心问题 | 关键形式 |
|---|---|---|
| 自动机 | 系统为了未来行为要记住什么? | 状态 + 输入 + 转移 |
| 可判定性 | 是否存在总能终止并给出答案的算法? | YES/NO 问题 |
| 复杂性 | 算法需要多少资源? | 时间、空间等 |
| 直接证明 | 如何从假设推出结论? | \(P\Rightarrow Q\) |
| 集合相等 | 如何证明两个集合完全一致? | 双包含 |
| 逆否 | 正面难推时怎么办? | \(\neg Q\Rightarrow\neg P\) |
| 反证 | 否定结论会怎样? | 推出矛盾 |
| 反例 | 如何推翻全称命题? | 找一个失败对象 |
| 整数归纳 | 如何证明无穷多个整数情况? | 基础 + \(k\to k+1\) |
| 结构归纳 | 如何证明所有递归结构? | 基础构件 + 构造规则 |
| 字母表 | 可以使用哪些原子符号? | \(\Sigma\) |
| 串 | 符号组成的有限序列 | \(w\in\Sigma^*\) |
| 空串 | 长度为 0 的串 | \(\varepsilon\) |
| 语言 | 哪些串属于目标集合? | \(L\subseteq\Sigma^*\) |
| 判定问题 | 哪些实例答案为 YES? | YES 编码组成语言 |
22 21. 与后续章节的连接
本章的概念会按下面的路线继续生长:
状态直觉
  ↓
DFA / NFA / ε-NFA(第2章)
  ↓
正则表达式与表示等价(第3章)
  ↓
泵引理、封闭性、最小化(第4章)

字符串 / 语言
  ↓
CFG(第5章)
  ↓
PDA(第6章)
  ↓
CFL 的性质(第7章)

问题 = 语言
  ↓
图灵机(第8章)
  ↓
不可判定性与归约(第9章)
  ↓
P / NP / NP 完全性(第10章)
证明方法同样贯穿全书:
- 双包含:证明语言等价;
- 归纳:证明扩展转移函数、递归结构性质;
- 结构归纳:证明正则表达式、文法结构上的命题;
- 反证:不可判定性;
- 反例:推翻封闭性猜想或错误等价命题。
23 22. 学习完成标准
如果不看教材,你应该能独立回答下面这些问题:
- 为什么“状态”可以理解为对历史的压缩?
- 自动机理论中的“可判定性”和“复杂性”有什么区别?
- 为什么证明 \(A=B\) 通常要证明两个包含关系?
- 原命题、逆命题、逆否命题之间是什么关系?
- 数学归纳法为什么不是“验证很多例子”?
- 结构归纳和普通整数归纳的对象有什么不同?
- \(\varnothing\)、\(\varepsilon\)、\(\{\varepsilon\}\) 分别是什么?
- \(\Sigma^*\) 为什么一定包含 \(\varepsilon\)?
- 语言为什么本质上只是字符串集合?
- 为什么一个判定问题可以编码成一个语言?
能清楚回答这 10 个问题,就具备进入第 2 章 DFA/NFA 的基础。