第 2 章 有穷自动机
DFA、NFA、子集构造、文本搜索与 ε-NFA
Source scope
本章以 Hopcroft–Motwani–Ullman《自动机理论、语言和计算导论》第三版中文译本第 2 章为主要依据:中文印刷页 25–56,对应 PDF p.38–69。教材第 3 章从 PDF p.70 开始。本文是自包含学习笔记而非逐字转写;为补足教材省略的推导、设计策略、证明中间步骤和额外例子而加入的内容,会标为“补充说明”或“扩展示例”。
1 0. 本章为什么是整门课的第一个核心章节
第 1 章给了我们三件工具:
- 用“状态”概括过去;
- 用形式语言表达待识别对象;
- 用归纳、双包含等方法完成证明。
第 2 章第一次把这三件事完整地合并起来。我们将定义一种真正的数学机器:有穷自动机(finite automaton)。它的状态数有限,每次只读一个输入符号,根据规则更新状态,最后根据所处状态决定是否接受输入串。
这一章最重要的不是“会画状态图”,而是理解以下主线:
DFA
  ↓ 放宽“每一步只有一个后继”
NFA
  ↓ 证明并没有增强语言识别能力
DFA ≡ NFA
  ↓ 加入不消耗输入的 ε 转移
ε-NFA
  ↓ 再次证明不增强语言识别能力
DFA ≡ NFA ≡ ε-NFA
后面的正则表达式、正则语言闭包、最小化、词法分析、模式匹配,都建立在这条等价链上。
1.1 0.1 学习目标
学完本章后,你应该能够:
- 写出 DFA、NFA、ε-NFA 的正式定义;
- 熟练在状态图、转移表和五元组之间转换;
- 正确使用扩展转移函数 \(\hat\delta\) 处理整个输入串;
- 用 \(L(A)\) 表示自动机接受的语言;
- 从语言性质出发设计 DFA,而不是靠试箭头;
- 理解 NFA 的“非确定性”是同时保留所有可能路径,不是随机选择一条;
- 完成 NFA \(\to\) DFA 的子集构造;
- 证明子集构造为什么保持语言不变;
- 计算 ε-closure,并把 ε-NFA 转换为 DFA;
- 用 NFA 表达文本搜索、关键词匹配等模式匹配任务。
2 1. 从“系统状态”到有穷自动机
2.1 1.1 有穷状态模型的基本假设
所谓“有穷自动机”,核心限制是:机器只能处于有限多个状态之一。
这意味着它不能把任意长输入的所有细节都记住。它只能保存有限种“摘要”。例如:
- 一个二进制串到目前为止出现了偶数个还是奇数个 \(1\);
- 到目前为止是否已经看到子串
011; - 当前读入的二进制数除以 \(3\) 的余数是 \(0,1,2\) 中哪一个;
- 当前后缀与模式
then的前缀匹配到了多长。
设计状态时最重要的问题不是“有几种历史”,而是:
哪些历史在未来行为上必须区分?
如果两个不同历史对任何未来输入都会产生相同接受/拒绝结果,那么它们原则上可以由同一个状态表示。
2.2 1.2 协议、控制器与状态机
教材在本章开头用协议和状态系统说明:很多真实系统并不是把所有历史都保存下来,而是维护少量控制状态,例如“正在等待确认”“已经发送请求”“出现错误”等。
形式化之后,系统必须回答三个问题:
- 当前有哪些可能状态?
- 每一种输入到来时,状态如何变化?
- 哪些状态代表“成功”或“接受”?
这三个问题正好对应后面 DFA 的 \(Q\)、\(\delta\) 和 \(F\)。
2.3 1.3 有穷自动机的局限性
有穷状态模型非常强大,但它的“记忆”是有限的。
例如,要识别
\[ L=\{0^n1^n\mid n\ge 0\}, \]
机器需要比较前面 \(0\) 的个数和后面 \(1\) 的个数。由于 \(n\) 没有上界,有限状态机无法用有限多个状态精确记住任意大的 \(n\)。
这里先只建立直觉;第 4 章会用泵引理等工具严格证明某些语言不是正则语言。
3 2. 确定型有穷自动机 DFA
3.1 2.1 正式定义
一个确定型有穷自动机(deterministic finite automaton, DFA)是五元组
\[ A=(Q,\Sigma,\delta,q_0,F), \]
其中:
- \(Q\):有限状态集合;
- \(\Sigma\):有限输入字母表;
- \(\delta:Q\times\Sigma\to Q\):转移函数;
- \(q_0\in Q\):初始状态;
- \(F\subseteq Q\):接受状态集合。
这一定义里最容易被忽略的是 \(\delta\) 的类型:
\[ \delta:Q\times\Sigma\to Q. \]
它表达了两件事。
3.1.1 确定性
给定当前状态 \(q\) 和输入符号 \(a\),下一状态只有一个:
\[ \delta(q,a)=p. \]
3.1.2 完备性
对每个 \((q,a)\in Q\times\Sigma\),\(\delta(q,a)\) 都必须有定义。
所以严格意义上的 DFA 不能“某个字符没有箭头”。如果设计图中省略了某些失败转移,正式化时通常补一个死状态(dead state / sink state)。
3.2 2.2 状态图与转移表
一个 DFA 常有三种等价表示:
- 五元组;
- 转移表;
- 转移图。
3.2.1 转移图约定
- 圆圈:状态;
- 指向某状态的无来源箭头:初始状态;
- 双圈:接受状态;
- 标有 \(a\) 的边 \(q\to p\):\(\delta(q,a)=p\)。
3.2.2 转移表约定
每一行对应一个状态,每一列对应一个输入符号。
例如识别“二进制串中 \(1\) 的个数为奇数”的 DFA:
| 状态 | 输入 0 | 输入 1 |
|---|---|---|
| \(q_e\)(偶数个 1) | \(q_e\) | \(q_o\) |
| \(q_o\)(奇数个 1) | \(q_o\) | \(q_e\) |
初始状态是 \(q_e\),接受状态是 \(q_o\)。
3.3 2.3 状态设计的核心:写“状态含义”而不是先画箭头
一个可靠的 DFA 设计过程是:
- 写出语言要记住的信息;
- 把“信息的可能取值”变成状态;
- 再根据输入如何改变信息来写转移;
- 最后判断哪些信息状态满足接受条件。
例如“\(1\) 的个数模 \(3\) 为 \(2\)”:
\[ Q=\{q_0,q_1,q_2\}, \]
其中 \(q_i\) 表示“目前 \(1\) 的个数模 \(3\) 为 \(i\)”。
读到 \(0\) 不改变余数;读到 \(1\) 让余数加一模 \(3\)。于是所有转移几乎自动得到。
常见错误:给状态起名
A/B/C后反复试箭头。
更好的方法:先写不变量,例如“状态 \(q_2\) 当且仅当目前读过的串中 \(1\) 的个数模 3 为 2”。
4 3. DFA 怎样处理一个完整的串
普通转移函数 \(\delta(q,a)\) 只读一个符号。为了处理整个串,需要定义扩展转移函数
\[ \hat\delta:Q\times\Sigma^*\to Q. \]
4.1 3.1 递归定义
基础情况:
\[ \hat\delta(q,\varepsilon)=q. \]
递归情况:若 \(w\in\Sigma^*\),\(a\in\Sigma\),则
\[ \hat\delta(q,wa)=\delta(\hat\delta(q,w),a). \]
意思是:
- 先读完前缀 \(w\);
- 得到状态 \(\hat\delta(q,w)\);
- 再读最后一个符号 \(a\)。
4.2 3.2 拼接性质
对任意 \(x,y\in\Sigma^*\),有
\[ \hat\delta(q,xy) = \hat\delta(\hat\delta(q,x),y). \]
这是一个非常重要的“分段处理”性质。
4.2.1 为什么成立
可以对 \(|y|\) 做归纳。
基础: \(y=\varepsilon\)。
\[ \hat\delta(q,x\varepsilon)=\hat\delta(q,x) = \hat\delta(\hat\delta(q,x),\varepsilon). \]
归纳步: 设对 \(y\) 成立,考虑 \(ya\):
\[ \begin{aligned} \hat\delta(q,xya) &=\delta(\hat\delta(q,xy),a)\\ &=\delta(\hat\delta(\hat\delta(q,x),y),a)\\ &=\hat\delta(\hat\delta(q,x),ya). \end{aligned} \]
因此成立。
这一性质后面会反复用于:
- 自动机等价证明;
- 正则语言闭包;
- 最小化;
- 泵引理;
- 字符串分段讨论。
5 4. DFA 的语言
给定 DFA
\[ A=(Q,\Sigma,\delta,q_0,F), \]
其接受语言定义为
\[ L(A)=\{w\in\Sigma^*\mid \hat\delta(q_0,w)\in F\}. \]
这句话需要非常熟练:
从初始状态开始读完整个串,如果最终状态属于接受状态集合,就接受该串。
5.1 4.1 “到过接受状态”不等于“接受”
DFA 的接受条件只看输入读完时的状态。
如果中途进入接受状态、后来又离开,而最终停在非接受状态,则输入仍被拒绝。
这在设计“包含某个子串”的 DFA 时尤其重要。若一旦看见目标子串就应永久接受,必须让后续状态保持“已经看见过”的信息,通常使用接受汇状态或接受区域。
6 5. DFA 设计的四类典型套路
6.1 5.1 奇偶性与模计数
语言:
\[ L=\{w\in\{0,1\}^*\mid \#_1(w)\equiv 1\pmod 2\}. \]
只需两个状态:偶数、奇数。
更一般地,如果要记录某个计数模 \(m\),通常需要 \(m\) 个状态。
6.2 5.2 固定后缀
例如识别所有以 011 结尾的串。
状态可以表示:当前后缀与目标 011 的最长前缀匹配到了多长。
- \(q_0\):没有有效匹配;
- \(q_1\):当前后缀为
0; - \(q_2\):当前后缀为
01; - \(q_3\):当前后缀为
011。
困难点是“失败后退到哪里”,本质上是保留最长仍有希望成为模式前缀的后缀。
6.3 5.3 包含某个子串
例如包含 101。
一旦完整看见 101,以后无论读什么都应该保持“已经出现过”这个事实,因此接受状态通常有对所有字符的自环。
6.4 5.4 数值取模
若把二进制串 \(w\) 看成一个二进制整数,当前余数 \(r\) 在读入新位 \(b\in\{0,1\}\) 后变成
\[ r'=(2r+b)\bmod m. \]
因此“二进制值可被 \(m\) 整除”的 DFA 可直接使用余数 \(0,1,\dots,m-1\) 作为状态。
这是把“无限多个整数”压缩成“有限多个同余类”的典型方法。
7 6. 非确定型有穷自动机 NFA
7.1 6.1 为什么引入非确定性
DFA 每一步必须唯一决定下一状态。有时这让设计变得笨重。
NFA 允许:
- 对同一个输入符号有多个可能后继;
- 某个输入符号没有任何后继。
这使得我们可以把“猜测某个位置是模式起点”直接写进自动机。
例如,要识别所有以 01 结尾的二进制串,可以让初始状态一直扫描,并在某个 \(0\) 上同时:
- 留在扫描状态;
- 猜测“这个 0 就是最后两个字符中的第一个”,进入匹配分支。
7.2 6.2 正式定义
NFA 仍写成五元组
\[ N=(Q,\Sigma,\delta,q_0,F), \]
区别只在转移函数:
\[ \delta:Q\times\Sigma\to 2^Q. \]
也就是说,\(\delta(q,a)\) 不再是一个状态,而是状态集合。
例如:
\[ \delta(q_0,0)=\{q_0,q_1\} \]
表示读到 \(0\) 后,两条可能路径同时存在。
7.3 6.3 最关键的理解:NFA 不是“随机机”
下面三种理解中,只有第三种正确:
- ❌ 每次随机选一条边;
- ❌ 机器神奇地提前知道哪条路会成功;
- ✅ 数学上同时考虑所有可能路径,只要至少一条路径最终接受,就接受输入。
因此 NFA 的接受是存在量词:
\[ w\in L(N) \iff \exists\text{ 一条处理 }w\text{ 的路径最终到达 }F. \]
8 7. NFA 的扩展转移函数
因为 NFA 同时可能处于多个状态,所以扩展转移函数返回状态集合:
\[ \hat\delta:Q\times\Sigma^*\to 2^Q. \]
8.1 7.1 基础情况
\[ \hat\delta(q,\varepsilon)=\{q\}. \]
8.2 7.2 递归情况
若 \(w\in\Sigma^*\),\(a\in\Sigma\),则
\[ \hat\delta(q,wa) = \bigcup_{p\in\hat\delta(q,w)}\delta(p,a). \]
这条公式的含义是:
- 读完 \(w\) 后可能在一组状态 \(S\);
- 从 \(S\) 中每个状态读 \(a\);
- 把所有后继做并集。
如果某一路径走不下去,它只贡献空集,并不会让其他路径失败。
8.3 7.3 NFA 的语言
\[ L(N)=\{w\in\Sigma^*\mid \hat\delta(q_0,w)\cap F\neq\varnothing\}. \]
不是要求所有可能状态都接受,而是要求至少一个接受状态可达。
9 8. DFA 与 NFA 等价:子集构造
这是本章最重要的定理之一。
定理:对任意 NFA \(N\),都存在 DFA \(D\),使得 \[ L(D)=L(N). \]
直觉上,DFA 虽然不能“同时走多条路”,但可以把 NFA 当前所有可能状态的集合整体记成一个 DFA 状态。
9.1 8.1 构造
设
\[ N=(Q_N,\Sigma,\delta_N,q_0,F_N). \]
构造 DFA
\[ D=(Q_D,\Sigma,\delta_D,\{q_0\},F_D), \]
其中:
\[ Q_D=2^{Q_N}. \]
也就是 NFA 状态集合的幂集。
DFA 的转移定义为
\[ \delta_D(S,a) = \bigcup_{q\in S}\delta_N(q,a). \]
接受状态集合为
\[ F_D=\{S\subseteq Q_N\mid S\cap F_N\neq\varnothing\}. \]
9.2 8.2 为什么接受条件是“集合中包含至少一个 NFA 接受状态”
DFA 状态 \(S\) 的语义是:
NFA 读到当前位置后,可能处于 \(S\) 中任意状态。
NFA 只需要一条路径成功,所以只要
\[ S\cap F_N\neq\varnothing, \]
就应让对应 DFA 状态接受。
9.3 8.3 正确性证明
核心不变量是:对任意 \(w\in\Sigma^*\),
\[ \hat\delta_D(\{q_0\},w) = \hat\delta_N(q_0,w). \]
左边虽然形式上是“DFA 的一个状态”,但这个状态本身就是 NFA 状态的集合。
9.3.1 对 \(|w|\) 归纳
基础: \(w=\varepsilon\)。
\[ \hat\delta_D(\{q_0\},\varepsilon)=\{q_0\} = \hat\delta_N(q_0,\varepsilon). \]
归纳步: 假设对 \(w\) 成立,考虑 \(wa\):
\[ \begin{aligned} \hat\delta_D(\{q_0\},wa) &=\delta_D(\hat\delta_D(\{q_0\},w),a)\\ &=\delta_D(\hat\delta_N(q_0,w),a)\\ &=\bigcup_{p\in\hat\delta_N(q_0,w)}\delta_N(p,a)\\ &=\hat\delta_N(q_0,wa). \end{aligned} \]
于是:
\[ \begin{aligned} w\in L(D) &\iff \hat\delta_D(\{q_0\},w)\cap F_N\neq\varnothing\\ &\iff \hat\delta_N(q_0,w)\cap F_N\neq\varnothing\\ &\iff w\in L(N). \end{aligned} \]
因此
\[ L(D)=L(N). \]
9.4 8.4 为什么最坏情况下会有 \(2^n\) 个状态
如果 NFA 有 \(n\) 个状态,那么它的状态子集共有
\[ 2^n \]
个。
因此子集构造可能造成指数级状态增长。
但实际构造时只需要生成从初始子集可达的子集,通常远少于全部 \(2^n\) 个。
9.5 8.5 空集状态就是死状态
如果某个集合状态 \(S\) 在字符 \(a\) 上没有任何后继,则
\[ \delta_D(S,a)=\varnothing. \]
而从 \(\varnothing\) 出发,对任意字符仍得到 \(\varnothing\)。
所以 \(\varnothing\) 在子集构造后的 DFA 中自然扮演死状态。
10 9. “缺少转移”的自动机与死状态
教材特别提醒:图上省略某些转移的自动机严格说可能不是完整 DFA,但可以通过加入一个死状态把它补全。
设新死状态为 \(d\):
- 所有原来“没有定义”的转移都指向 \(d\);
- 对每个 \(a\in\Sigma\),令 \(\delta(d,a)=d\)。
这不会改变原本想表达的语言,因为一旦进入死状态就永远无法接受。
这个技巧在手画自动机时很常见:
图上可以为了简洁省略“显然进入失败状态”的边,但正式五元组里必须知道这些边其实去死状态。
11 10. 应用:文本搜索
11.1 10.1 为什么 NFA 很适合搜索
文本搜索的典型任务是:
在很长的字符流中,判断某个关键词是否在任意位置出现。
如果关键词是 web,可以让扫描状态对任意字符自环,同时每当看到 w 时,额外启动一条“可能正在匹配 web”的路径。
如果同时搜索 web 和 ebay,NFA 可以让扫描态分叉到多个关键词分支。
这种设计体现了 NFA 的优势:
- 结构接近问题描述;
- 可以共享扫描状态;
- 可以同时保留多个候选匹配起点。
11.2 10.2 从 NFA 到真正运行的 DFA
理论上可以直接模拟 NFA 的状态集合,也可以先做子集构造得到 DFA。
如果文本很长、模式固定,DFA 的每字符处理可以非常直接:
\[ \text{current state} \xrightarrow{\text{one character}} \text{next state}. \]
因此“用 NFA 设计、用 DFA 执行”是一个很自然的工作流。
12 11. 带 ε 转移的 NFA
12.1 11.1 ε 转移是什么
ε-NFA 允许标记为 \(\varepsilon\) 的边。走这条边时:
状态改变,但不消耗输入符号。
这非常适合把多个小自动机模块拼接起来。
例如要表达“先完成模式 A,再进入模式 B”,可以从 A 的接受端通过 ε 边进入 B 的起点。
12.2 11.2 ε-NFA 的形式化转移函数
一种常用写法是
\[ \delta:Q\times(\Sigma\cup\{\varepsilon\})\to 2^Q. \]
注意这里的 \(\varepsilon\) 不是字母表里的普通字符。它代表“什么都不读”。
13 12. ε-closure
13.1 12.1 定义
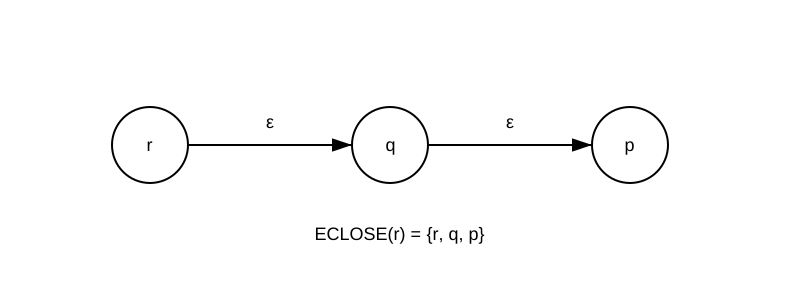
状态 \(q\) 的 ε-闭包(epsilon-closure),记为
\[ \operatorname{ECLOSE}(q), \]
是从 \(q\) 出发只沿 0 条或多条 ε 边可到达的所有状态。
因为允许走 0 条 ε 边,所以总有
\[ q\in\operatorname{ECLOSE}(q). \]
对状态集合 \(S\),定义
\[ \operatorname{ECLOSE}(S) = \bigcup_{q\in S}\operatorname{ECLOSE}(q). \]
13.2 12.2 算法直觉
计算 ε-closure 本质上是图上的可达性搜索:
- 把初始状态放入集合;
- 沿所有 ε 边继续扩展;
- 直到不能加入新状态。
可以用 DFS/BFS 完成。
14 13. ε-NFA 的扩展转移
处理一个普通输入符号时,必须记住三个阶段:
- 先做当前集合的 ε-closure;
- 消耗一个真实输入符号;
- 再做新集合的 ε-closure。
若当前集合为 \(S\),字符为 \(a\),可以写成
\[ \operatorname{Move}(S,a) = \bigcup_{q\in S}\delta(q,a), \]
然后
\[ T= \operatorname{ECLOSE}(\operatorname{Move}(\operatorname{ECLOSE}(S),a)). \]
如果我们始终维护“已经闭包过”的状态集合,则每一步可简化为
\[ T= \operatorname{ECLOSE}\left( \bigcup_{q\in S}\delta(q,a) \right). \]
15 14. ε-NFA 的接受
初始时不能只从 \(\{q_0\}\) 开始,而应先计算
\[ S_0=\operatorname{ECLOSE}(q_0). \]
读完整个输入后,如果当前状态集合与接受集合有非空交集,则接受。
特别地,空串 \(\varepsilon\) 是否被接受,要看
\[ \operatorname{ECLOSE}(q_0)\cap F\neq\varnothing \]
是否成立。
这也是最常见的易错点之一:
ε-NFA 可能在一个真实字符都没读的情况下就到达接受状态,因此可能接受空串。
16 15. ε-NFA 仍然没有增强识别能力
我们可以直接把 ε-NFA 转为 DFA。
构造时:
- DFA 初始状态是 \(\operatorname{ECLOSE}(q_0)\);
- 对 DFA 集合状态 \(S\) 和字符 \(a\):
\[ \delta_D(S,a) = \operatorname{ECLOSE}\left( \bigcup_{q\in S}\delta_N(q,a) \right); \]
- 若 \(S\cap F_N\neq\varnothing\),则 \(S\) 是接受状态。
因此:
\[ \boxed{\text{DFA}\equiv\text{NFA}\equiv\varepsilon\text{-NFA}} \]
这里的“等价”是语言表达能力相同,不是“状态数相同”“结构相同”或“设计难度相同”。
17 16. 三种自动机的区别与统一
| 模型 | 单步转移 | 可无转移 | 可多个后继 | 可不读字符转移 | 接受条件 |
|---|---|---|---|---|---|
| DFA | \(Q\times\Sigma\to Q\) | 否 | 否 | 否 | 唯一最终状态在 \(F\) |
| NFA | \(Q\times\Sigma\to 2^Q\) | 是 | 是 | 否 | 至少一条路径到 \(F\) |
| ε-NFA | \(Q\times(\Sigma\cup\{\varepsilon\})\to 2^Q\) | 是 | 是 | 是 | ε-扩展后的某条路径到 \(F\) |
统一视角:
三者都识别且仅识别正则语言。
正则语言这个术语将在第 3 章与正则表达式正式汇合。
18 17. 常见错误
18.1 17.1 把 NFA 当成“任选一条路”
错误:
“这里有两条边,我选其中一条。”
正确:
两条可能性都要保留;只要其中至少一条最终接受,NFA 就接受。
18.2 17.2 子集构造时只取一个后继
若 \(S=\{p,q\}\),则
\[ \delta_D(S,a)=\delta_N(p,a)\cup\delta_N(q,a). \]
不是任选其中一个。
18.3 17.3 忘记空集状态
如果某个集合在某字符上没有后继,结果是
\[ \varnothing, \]
而不是“没有状态所以表格留空”。在 DFA 中它就是一个合法的死状态。
18.4 17.4 ε-closure 不包含自身
错误:只列通过至少一条 ε 边能到的状态。
正确:0 条 ε 边也允许,所以
\[ q\in\operatorname{ECLOSE}(q). \]
18.5 17.5 把 ε 当作一个输入字符
ε 转移不消耗任何输入。若输入是 ab,走 ε 边以后输入仍然是 ab,不会变成只剩 b。
18.6 17.6 只检查“到过接受状态”
自动机的接受判定发生在整个输入处理完以后。中途到过接受状态并不自动意味着最终接受,除非自动机设计保证之后不会失去接受性质。
19 18. 本章知识关系图
State / Transition
      ↓
     DFA
      ↓ define extended transition
   δ-hat on strings
      ↓
    L(DFA)
      ↑
subset construction
      ↑
     NFA
      ↓ convenient design
 text search / pattern matching
      ↑
   ε-closure
      ↑
   ε-NFA
20 19. 学习检查清单
完成本章后,建议不看笔记独立回答:
21 20. 进入第 3 章前必须真正掌握的三件事
如果时间有限,至少确保以下三点已经能独立完成:
- 设计 DFA:从“应该记住什么信息”出发定义状态含义;
- 子集构造:手算 NFA \(\to\) DFA,并明确每个集合状态的语义;
- ε-closure:正确处理 ε-NFA 的初始闭包和每一步闭包。
第 3 章将引入正则表达式。届时最重要的结论会变成:
\[ \text{Regular Expression} \equiv \varepsilon\text{-NFA} \equiv \text{NFA} \equiv \text{DFA}. \]
因此第 2 章的等价构造不是一次性技巧,而是后续整个正则语言理论的基础。